ESP32-S3を7台つないでLLMを分散実行、1.58ビット化した0.5Bモデルを分担
3行でわかる
- ESP32-S3を7台SPIで数珠つなぎにし、Qwen2-0.5Bをもとにした言語モデルを分散して動かすクラスターがGitHubで公開された
- このクラスターは重みを1.58ビット(-1・0・1の3値)に量子化し、1台あたり4層・約15.3MBに収めて6台で24層を分担する
- 作者によると学習が足りず出力はまだ意味のないトークン列で、Hacker Newsでは150ポイントを集め実用性をめぐる議論になった
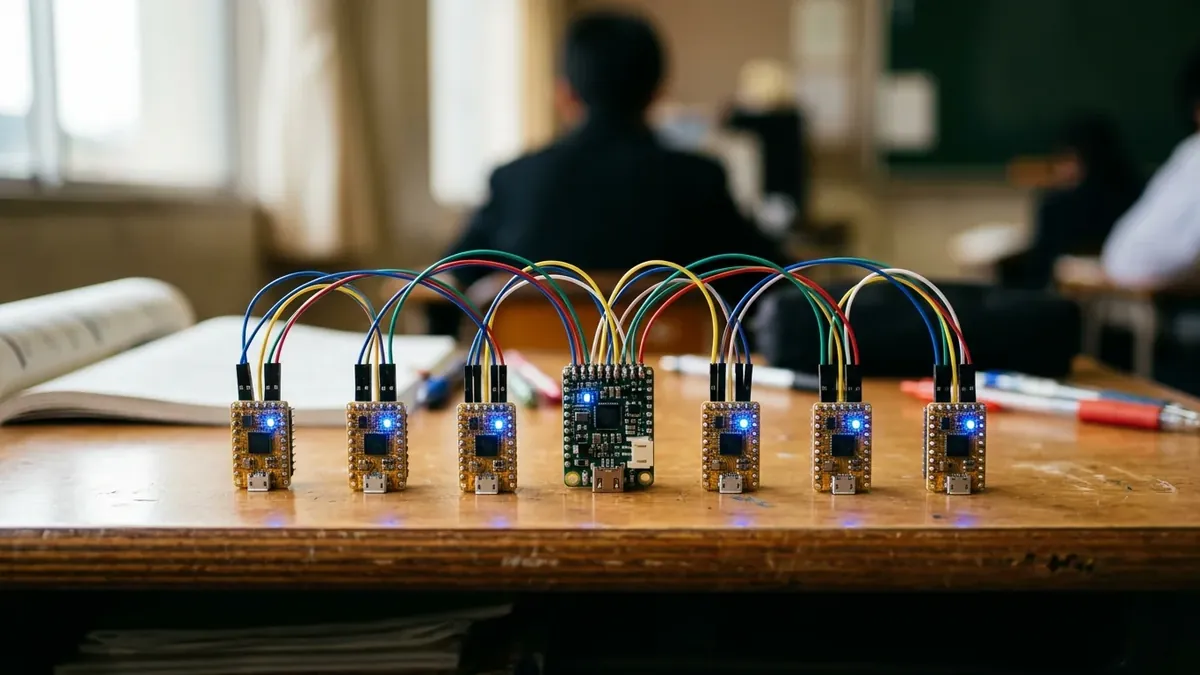
GitHubのプロフィールにコンピューターサイエンス専攻の大学1年生と書く開発者Low-Zi-Hongが、小型マイコン「ESP32-S3」を7台つないで言語モデルを動かすクラスターを公開しました。重みを1.58ビットに縮めたQwen2-0.5Bベースのモデルを、6台が4層ずつ分担して計算します。米国時間9月28日にHacker Newsで紹介され、150ポイントを集めました。
何を作ったか
ESP32s3-LLM-Clusterとは、ESP32-S3を複数台並べ、言語モデルの層を受け持たせて順番に計算する「パイプライン推論」の仕組みです。1台が親機として文章をトークン(単語の断片)に分けて数値に変え、残りの6台が順番にTransformerの層を計算して、結果を親機に戻します。親機が次の1語を選び、これを繰り返して文章を作ります。
台どうしは、SPIという単純な通信線を数珠つなぎにして結んでいます。ESP32-S3はメモリが小さく(このプロジェクトは1台あたり16MBのフラッシュを前提にしています)、モデル全体は1台に入りません。そこで層を分けて複数台に載せる、という発想です。
公式ドキュメントLow-Zi-Hong/ESP32s3-LLM-Cluster
どう作ったか
もとにしたモデルは、AlibabaのQwenシリーズの小型モデルQwen2-0.5Bです。縮め方は3段階です。
- 語彙を約15万1000語から3万2000語に削り、単語の表(埋め込み)を4ビットにして親機のフラッシュ約14MBに収める。作者によると3万2000語が上限で、それを超えると16MBに収まらない
- 各層の重みを、MicrosoftのBitNetの考え方にならって-1・0・1の3値(1.58ビット)に量子化する。3値を前提に追加学習するPythonのスクリプトも同梱した
- 3値の重みを1バイトに4つ詰め、1層あたり約3.82MB、1台4層で約15.3MBにする。3値の掛け算はアセンブリで最適化した
扱える文脈の長さは512トークンで、途中の計算結果(KVキャッシュ)は各台の外部メモリ(PSRAM)に置きます。電力は待機時に約1.17W、推論中に約1.53Wだったと作者は書いています。コミットの記録では、8月6日に開発を始め、8月20日に「完全に動く版」をコミットしています。
成果と限界
作者は限界をはっきり書いています。同梱の量子化学習スクリプトは途中までしか学習しておらず、出力は意味のないトークンの羅列になるといいます。より強い計算機で学習し直すよう勧めています。
This script just partially train, the loss will hit somekind of 8.0. It will be just spitting out random tokens..
このスクリプトは部分的にしか学習しないため、損失は8.0前後になります。出力はランダムなトークンを吐き出すだけになります。
原文を読む(github.com)つまり現時点では、意味の通る答えを返すチャットボットではありません。マイコンを束ねて24層のモデルを最後まで計算させる仕組みの実証です。速度について作者は、現状では各台の推論に1.3秒かかり、台数を増やせば大きなモデルも載せられる一方、推論時間は台数に比例して伸びると説明しています。
反応と論点
Hacker Newsのコメントは31件でした。「圧縮しすぎて凝ったノイズ発生器になっているのは残念だが、それでも魅力的」という感想や、性能の高いEspressifの新しいチップならどうか、という期待が寄せられました。
技術面では、LLMの速度を決めるのはメモリの帯域で、チップの外に出るほど通信が遅くなるため、多数の小型チップを束ねる方式は割に合わないという指摘が出ました。数珠つなぎのSPIは台数を増やすほど通信が難しくなるという意見や、実用目的ならシングルボードコンピューターや小型PCが向いているという書き込みもありました。
日本のビジネスへの影響
ライセンスはMITで、商用を含め自由に改変できます。必要なのは16MBフラッシュとPSRAMを持つESP32-S3が7台と配線、電源です。作者はボードの価格を書いていません。書き込み用のスクリプトはWindowsの.batで、READMEに日本語の扱いについての記載はありません。
すぐ業務に使える成果物ではありません。価値があるのは、量子化・層の分割・機器間通信というエッジAIの基本を手で確かめられる教材としての面です。組み込み機器メーカーの研究開発担当や、高専・大学でAIハードウェアを教える人に向いています。今すぐやれることは、モデル仕様の表と量子化スクリプトを読み、自社の機器にどの規模のモデルが載るかを見積もる材料にすることです。
実際に機器へ言葉の機能を載せたいなら、同じESP32-S3で動く音声認識Oídoのように、用途を絞った小さなモデルを選ぶほうが現実的です。手元で汎用のLLMを動かす選択肢はローカルLLM・オープンウェイトモデルのおすすめで整理しています。
注意点として、作者は、各台に書き込む層の順番を間違えてもエラーは出ず、意味のない出力になるだけで原因を突き止めにくいと書いています。全台でGND(電源のマイナス側)を共通にする必要もあります。
一次情報
- 公式ドキュメントGitHub Low-Zi-HongESP32s3-LLM-Cluster(README)
- 公式ドキュメントGitHub Low-Zi-HongFlashing and Preprocessing(workflow.md)
参考にした報道(1件)
AIデジマは、公式発表・X投稿・論文などの一次情報を起点に、複数の情報源を照合して日本語でまとめています。情報の収集・翻訳・下書き・照合にはAIを使い、編集方針と最終責任は編集長が負います(AIの活用について)。誤りを見つけた場合は訂正のご連絡をお願いします。